


Come addestrare un chatbot AI sui contenuti del sito
Per insegnare il sito a un chatbot basta indicizzare le pagine, senza riaddestrare il modello. Come si fa, quanto costa (meno di un centesimo) e come si verifica.
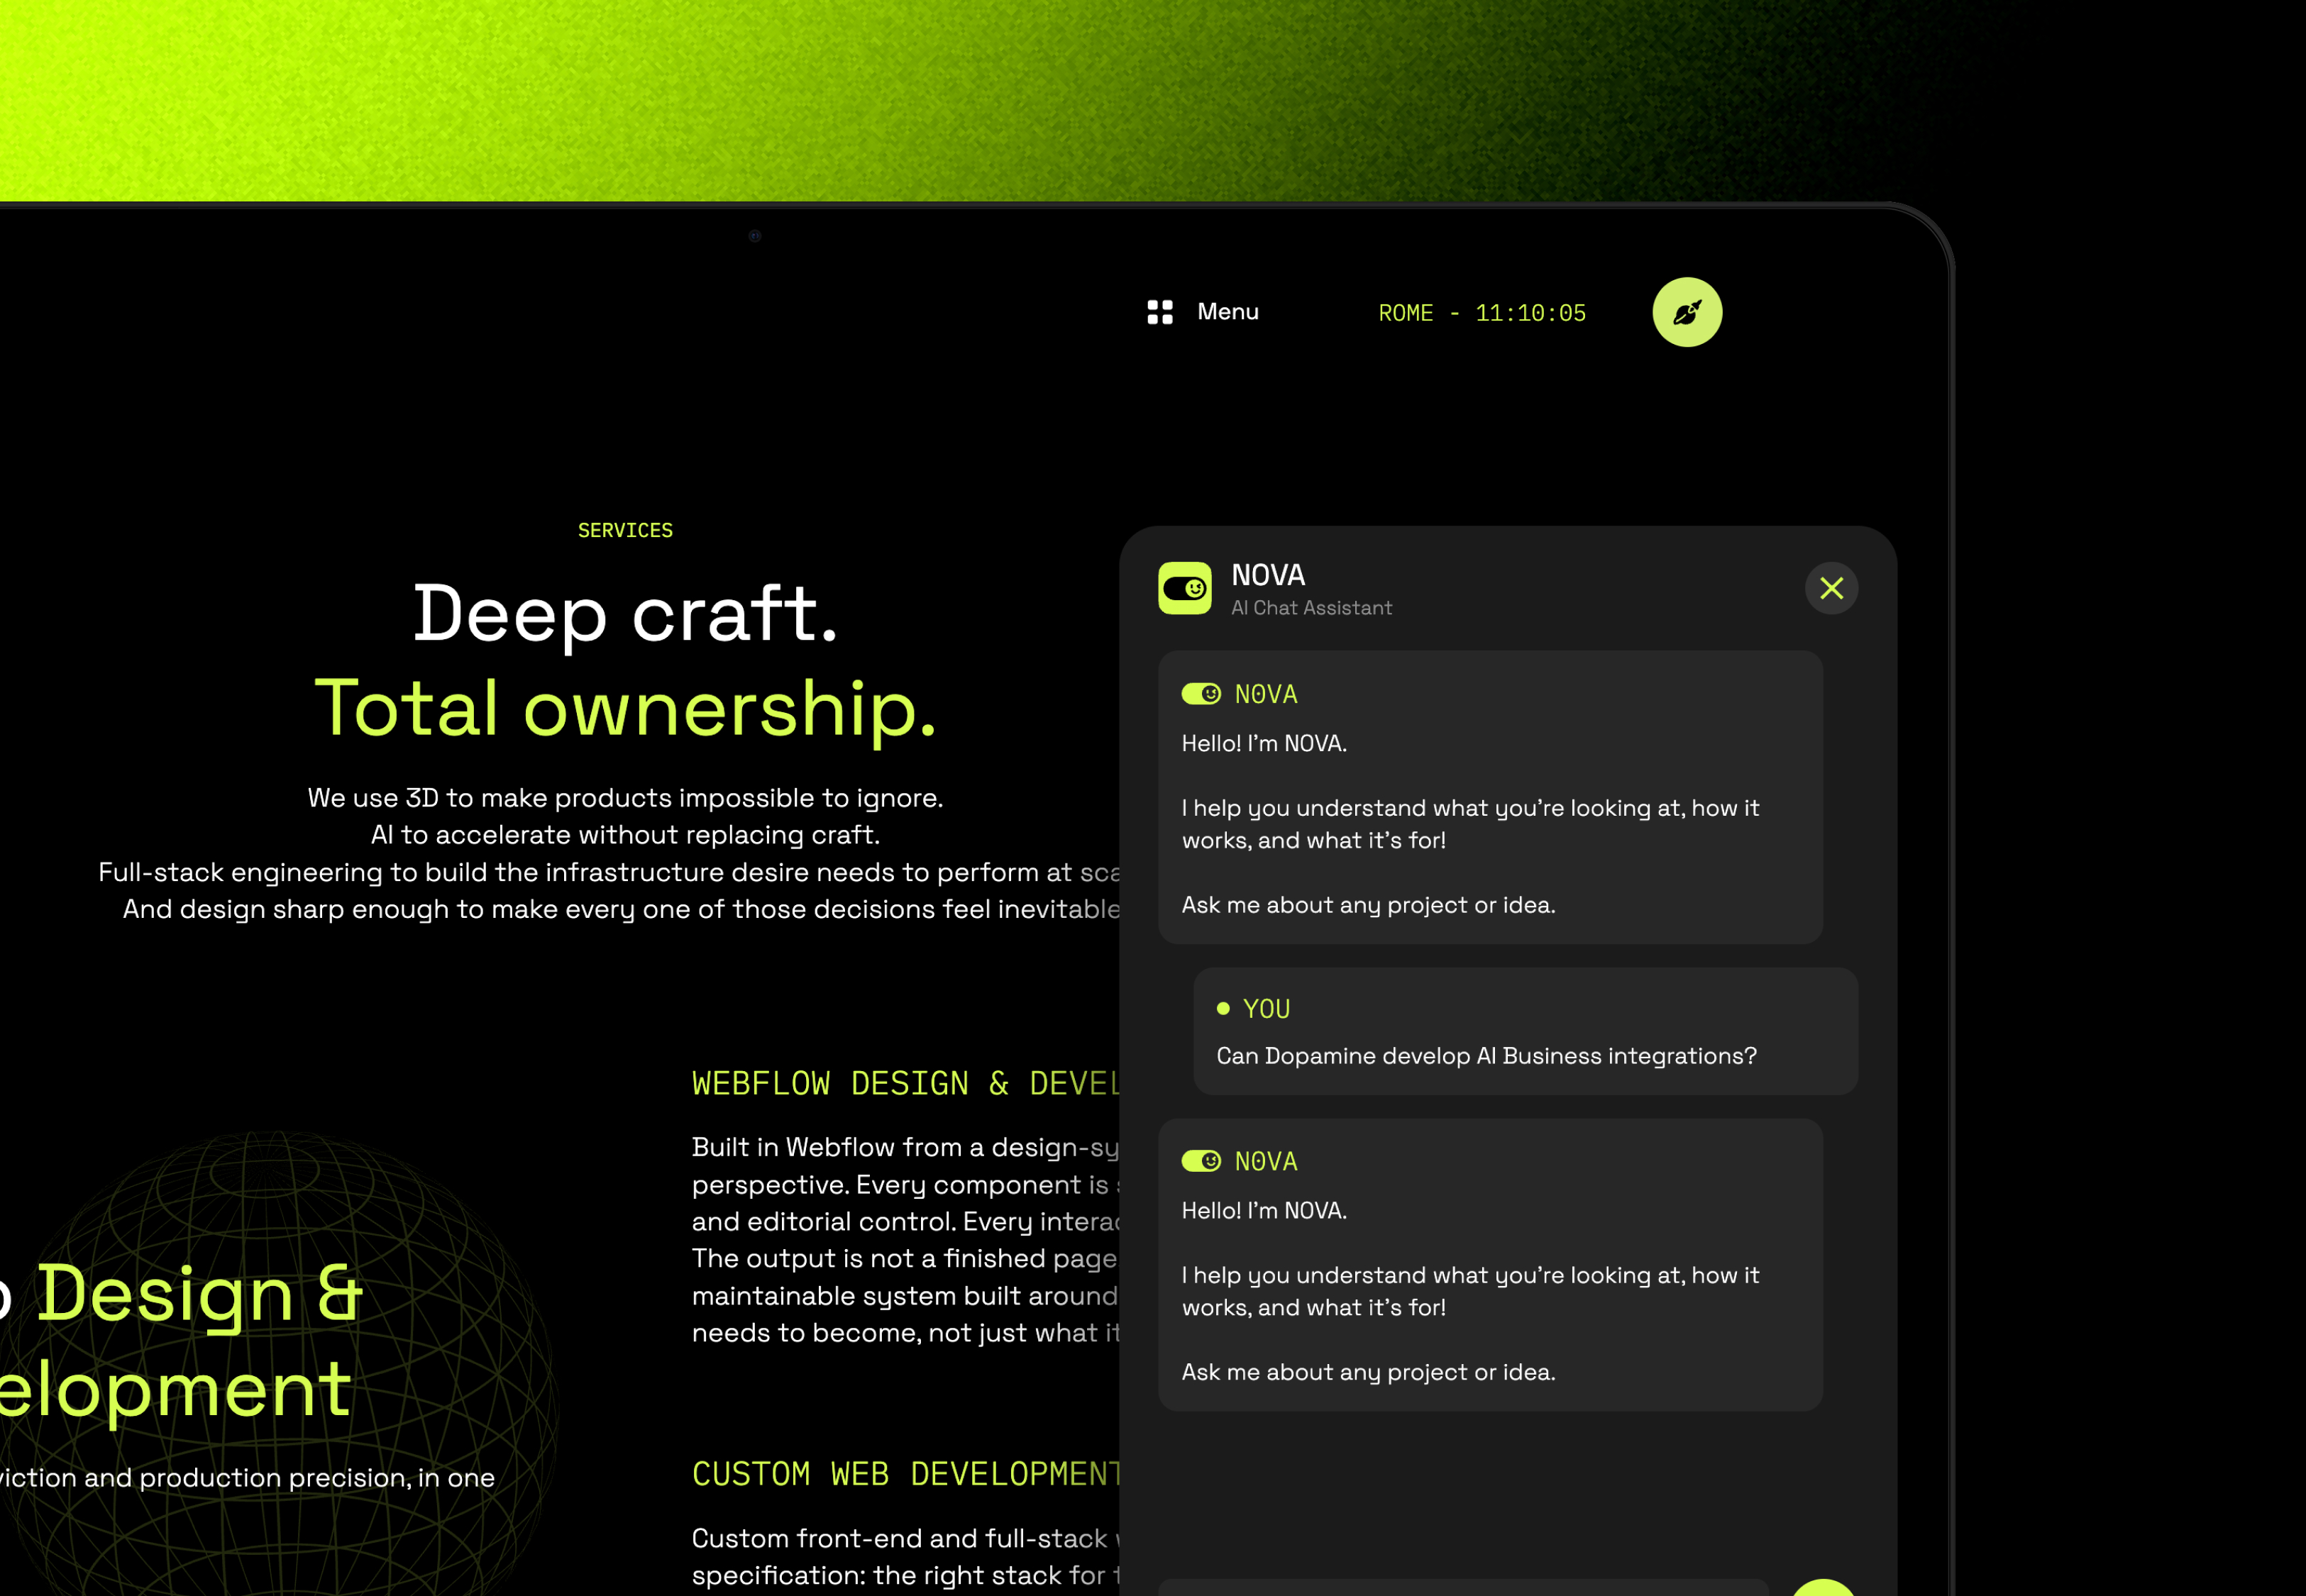
Tutti chiedono come addestrare un chatbot sul proprio sito. Quasi nessuno ne ha bisogno.
L'addestramento modifica il modello stesso ed è la strada lenta e costosa. Quello che serve è un chatbot che legga le pagine prima di rispondere. Il processo si chiama indicizzazione e trasforma il sito in un archivio che il modello consulta in pochi millisecondi, a ogni domanda di un visitatore.
La differenza conta più delle parole. Un modello addestrato ricorda una fotografia del sito, compresi gli errori che ha imparato. Un modello collegato a un indice legge la pagina attuale, la cita e si ferma dove la pagina finisce. Questa guida spiega la configurazione passo per passo, con i costi reali e un metodo per verificare il risultato. È lo stesso metodo su cui si basa N0VA, l'assistente del nostro sito.
Il tema riguarda sempre più aziende italiane. Secondo il rapporto Imprese e ICT di Istat, pubblicato a dicembre 2025, le imprese con almeno 10 addetti che usano l'intelligenza artificiale sono passate dall'8,2% del 2024 al 16,4% del 2025. Tra queste, il 70,8% la usa per estrarre informazioni da documenti di testo, che è proprio il lavoro di un chatbot collegato al sito.
In sintesi
- Un chatbot impara il sito tramite indicizzazione: il modello legge le pagine prima di ogni risposta, senza nuovo addestramento.
- La divisione delle pagine in chunk determina la precisione. Nei test di Anthropic del 2024, una preparazione migliore dei chunk ha ridotto i recuperi falliti dal 5,7% all'1,9%.
- Indicizzare un sito di 50 pagine costa una frazione di centesimo. Per tenerlo aggiornato basta un webhook di pubblicazione.
- Prima del lancio servono almeno 20 domande di prova con risposta nota, metà delle quali fuori dai contenuti del sito.
Serve davvero addestrare un chatbot sul sito?
No. Per i contenuti di un sito, il modello resta com'è e si collega alle pagine. La guida di OpenAI Optimizing LLM Accuracy divide il problema in due. Quando al modello mancano conoscenze proprietarie o aggiornate, si interviene sul contesto che riceve. Quando sono sbagliati il tono o il formato, si interviene sul modello.
Prezzi, servizi, condizioni di spedizione e tempi di reso sono problemi di conoscenza. Il modello non li ha mai visti, e cambiano. Per questo sono un compito per la retrieval-augmented generation (RAG), il metodo formalizzato da Lewis e colleghi nel 2020: prima si recuperano i passaggi rilevanti, poi si genera la risposta a partire da quelli.
Il fine-tuning ha un suo ruolo. Agisce sul comportamento del modello, ed è utile quando serve una voce o un formato di output molto specifico su larga scala. Per conservare informazioni funziona male, perché ogni modifica a una pagina richiederebbe un nuovo addestramento. La stessa OpenAI scrive che molte delle sue implementazioni più grandi presso i clienti si basano solo su prompt engineering e RAG.
Quando un fornitore parla di un chatbot «addestrato sul sito», quindi, la parola giusta è «indicizzato». La domanda successiva è ogni quanto si aggiorna l'indice.
Come impara un chatbot i contenuti del sito?
In due momenti distinti. Una prima volta, e poi a ogni pubblicazione, le pagine vengono ripulite, divise in brevi passaggi, convertite in numeri e salvate in un indice. Poi, a ogni domanda di un visitatore, il sistema cerca nell'indice e passa al modello i passaggi più vicini. Il modello risponde a partire da quelli, oppure declina.
La prima corsia è l'«addestramento» di cui si parla di solito. Lavora in background e nessuno la vede. La seconda è quella che vivono i visitatori, e funziona solo quanto la prima.
Ogni fase della prima corsia ha un compito preciso:
- Pulizia. Eliminare menu di navigazione, footer, banner dei cookie e testi ripetuti, così che resti solo il contenuto vero.
- Chunking. Dividere ogni pagina in passaggi, i chunk, abbastanza brevi da corrispondere a una singola domanda.
- Embedding. Convertire ogni passaggio in un vettore, una sequenza di numeri che ne rappresenta il significato. Significati simili finiscono vicini.
- Indicizzazione. Salvare i vettori in modo che il sistema trovi in pochi millisecondi quelli più vicini a una domanda.
Un chatbot addestrato sui contenuti di un sito funziona per recupero, il metodo descritto da Lewis e colleghi nel 2020. Le pagine vengono ripulite, divise in chunk, convertite in embedding e indicizzate in anticipo. A ogni domanda il sistema recupera i passaggi più vicini e il modello risponde a partire da quelli, oppure declina quando nulla corrisponde.
Quali pagine deve leggere il chatbot?
Solo quelle che l'azienda sottoscriverebbe se un cliente gliele citasse. Si parte da pagine di servizi e prodotti, prezzi, FAQ e condizioni di vendita. Restano fuori i contenuti superati o contraddittori, perché il modello ripete quello che recupera. Il caso Air Canada mostra cosa c'è in gioco: nel 2024 un tribunale della British Columbia ha ritenuto la compagnia responsabile (in inglese) di una politica di rimborso descritta dal suo chatbot.
Poi vanno sistemate le pagine stesse. È il passaggio che quasi tutti saltano e quello che rende di più.
- Un'informazione, un solo posto. Se i tempi di consegna compaiono su quattro pagine con tre numeri diversi, prima o poi il bot citerà quello sbagliato.
- Titoli che dicono qualcosa. «Prezzi dei retainer» dà al chunk un contesto. «Scopri di più» non ne dà nessuno.
- Prima la risposta, poi il dettaglio. I passaggi che si aprono con la risposta vengono recuperati e citati in modo pulito.
- Nomi coerenti. Se un prodotto ha due nomi sul sito, ne va scelto uno.
Un contenuto preparato per un chatbot è anche un contenuto preparato per la ricerca con l'IA. Le stesse pagine pulite, con la risposta in apertura, che aiutano l'assistente del sito sono quelle che ChatGPT e Perplexity citano più facilmente. Cos'è la generative engine optimization
Come si dividono le pagine in chunk?
Prima per significato, poi controllando la lunghezza. Lo strumento file search di OpenAI usa di default chunk da 800 token con 400 token di sovrapposizione, circa 600 parole di testo inglese con metà del contenuto ripetuta nel chunk successivo. Per documenti lunghi funziona. Per un sito, dividere a ogni titolo di sezione di solito rende di più, perché il titolo segna già dove finisce una risposta e comincia la successiva.
Il chunking sembra un dettaglio tecnico. Decide cosa il modello riesce a trovare.
Nel settembre 2024 Anthropic ha pubblicato Introducing Contextual Retrieval, uno studio che misura quanto spesso il passaggio giusto manca tra i primi 20 risultati. Con embedding standard mancava nel 5,7% dei casi. Aggiungere a ogni chunk una breve riga di contesto prima dell'embedding, per esempio la pagina e la sezione di provenienza, ha portato il dato al 3,7%. Affiancando la ricerca per parole chiave si è scesi al 2,9%, e con un passaggio di reranking all'1,9%.
Non serve applicare ogni tecnica dal primo giorno. Due abitudini coprono gran parte del guadagno:
- Anteporre a ogni chunk il titolo della pagina e della sezione. Un passaggio che dice «Da 2.500 €» da solo non significa nulla. «Retainer > Prezzi: da 2.500 €» significa qualcosa.
- Tenere interi tabelle ed elenchi. Una tabella prezzi spezzata in due chunk è una tabella che il bot non riesce a leggere.
Quanto costa indicizzare un sito?
Quasi nulla. Nel 2026 OpenAI applica al modello text-embedding-3-small un prezzo di 0,02 dollari per milione di token. Un sito di 50 pagine da circa 1.000 parole ciascuna corrisponde, secondo una nostra stima, a circa 65.000 token. Anche raddoppiando il conto per la sovrapposizione tra chunk e per i token in più che richiede l'italiano, una reindicizzazione completa resta sotto il mezzo centesimo di dollaro.
Per questo il costo di esercizio di un assistente si concentra quasi tutto nelle risposte. N0VA, l'assistente del nostro sito, usa questa architettura e costa meno di un dollaro al mese in chiamate al modello. Le due leve sono il modello che scrive le risposte e il numero di passaggi che legge per ogni domanda.
Il costo vero sta nel lavoro attorno all'indice: decidere a cosa può rispondere il bot, pulire i contenuti, scrivere la regola di rifiuto e testarla. Sono pochi giorni di lavoro concentrato, fatti una volta. [INTERNAL-LINK: Quanto costa un chatbot AI per il sito web
Come si tiene aggiornato il chatbot?
Reindicizzando in automatico a ogni modifica del sito. La Data API di Webflow supporta webhook per eventi come site_publish e collection_item_changed. Basta collegarne uno a una piccola funzione che riscansiona le pagine modificate e ne aggiorna i chunk: il bot conosce una pagina nuova pochi minuti dopo la pubblicazione.
Qui l'indicizzazione supera nettamente l'addestramento. Un modello con fine-tuning è una fotografia del sito nel giorno dell'addestramento. Un indice è uno specchio. Si cambia un prezzo alle 10, si pubblica, e la risposta delle 10:05 è già corretta.
Due accorgimenti tengono lo specchio pulito:
- Cancellare oltre che aggiungere. Quando una pagina viene rimossa, vanno rimossi anche i suoi chunk. Le pagine vecchie sono la causa più comune di risposte sbagliate date con sicurezza.
- Salvare l'URL di origine con ogni chunk. Così il bot collega ogni risposta alla pagina da cui viene, e ogni risposta sbagliata si può ricondurre alla pagina che l'ha causata.
Su WordPress e sugli altri CMS diffusi in Italia lo schema è lo stesso, tramite un webhook di pubblicazione o una scansione notturna programmata. Design e sviluppo Web
Come si verifica che l'addestramento abbia funzionato?
Con domande di prova dalla risposta nota, prima che arrivino i visitatori. La guida di OpenAI sull'accuratezza consiglia un set di valutazione di almeno 20 domande con risposte di riferimento, e di analizzare ogni errore prima di cambiare qualcosa. Per il bot di un sito, metà delle domande dovrebbe trovare risposta sul sito e metà no.
La seconda metà è quella che conta. Un bot che risponde a tutto è un bot che inventa. Per ogni domanda di prova vanno registrati quattro controlli:
- Il recupero ha trovato la pagina giusta? Se no, il problema sta nel chunking o nei contenuti.
- La risposta corrisponde alla pagina? Se no, vanno corrette le istruzioni al modello.
- Ha indicato la fonte? Ogni risposta dovrebbe rimandare a una pagina verificabile.
- Ha declinato quando doveva? Una domanda fuori tema dovrebbe chiudersi con il passaggio a una persona.
Lo stesso set va ripetuto dopo ogni modifica importante ai contenuti. Richiede dieci minuti e intercetta le regressioni prima di un cliente.
Per un sito che si rivolge al pubblico europeo c'è un ultimo controllo. Dal 2 agosto 2026 si applicano gli obblighi di trasparenza dell'articolo 50 dell'AI Act (Regolamento UE 2024/1689): i sistemi di IA che interagiscono con le persone devono essere progettati in modo che queste sappiano di parlare con un'IA, salvo che sia evidente dal contesto. Una riga chiara nel messaggio di benvenuto dell'assistente è il modo più diretto per rispettarlo.
In conclusione
Per insegnare un sito a un chatbot non serve addestrare nessun modello. Il lavoro somiglia più a una revisione editoriale che a un progetto di ingegneria: scegliere le pagine che l'azienda sottoscriverebbe, scriverle in modo che ogni risposta abbia un unico posto chiaro, dividerle dove cambia il significato e reindicizzarle a ogni pubblicazione. Fatto questo, il modello ha pochissimo margine per sbagliare. Un chatbot è preciso quanto i contenuti che legge, e spesso l'investimento migliore per l'assistente è un pomeriggio dedicato al proprio sito.
Si può collegare un modello come ChatGPT ai contenuti del sito, che è quello che quasi sempre si intende. Il modello legge le pagine indicizzate al momento della domanda, senza nuovo addestramento. La guida di OpenAI tratta la mancanza di conoscenze proprietarie come un problema di contesto, da risolvere con il recupero.
Di norma no, ed è giusto così. Un bot basato sul recupero risponde solo a partire dalle pagine indicizzate, quindi nessun visitatore può insegnargli qualcosa di falso. I registri delle conversazioni servono a scoprire le domande a cui il sito non risponde ancora: quei contenuti si aggiungono al sito e si reindicizzano.
Nell'Unione Europea sì, salvo che sia evidente dal contesto. L'articolo 50 dell'AI Act, applicabile dal 2 agosto 2026, richiede che chi interagisce con un sistema di IA ne sia informato. Un messaggio di benvenuto che presenta l'assistente come IA è il modo più diretto per farlo.
Con un webhook di pubblicazione attivo, la pagina modificata viene reindicizzata in pochi minuti e la risposta successiva ne tiene conto. Webflow lo supporta con il webhook site_publish e con quelli degli elementi CMS. Senza automazione, il bot continua a citare la versione vecchia finché qualcuno non reindicizza a mano.


